Sitemap y robots.txt: qué son y cómo configurarlos
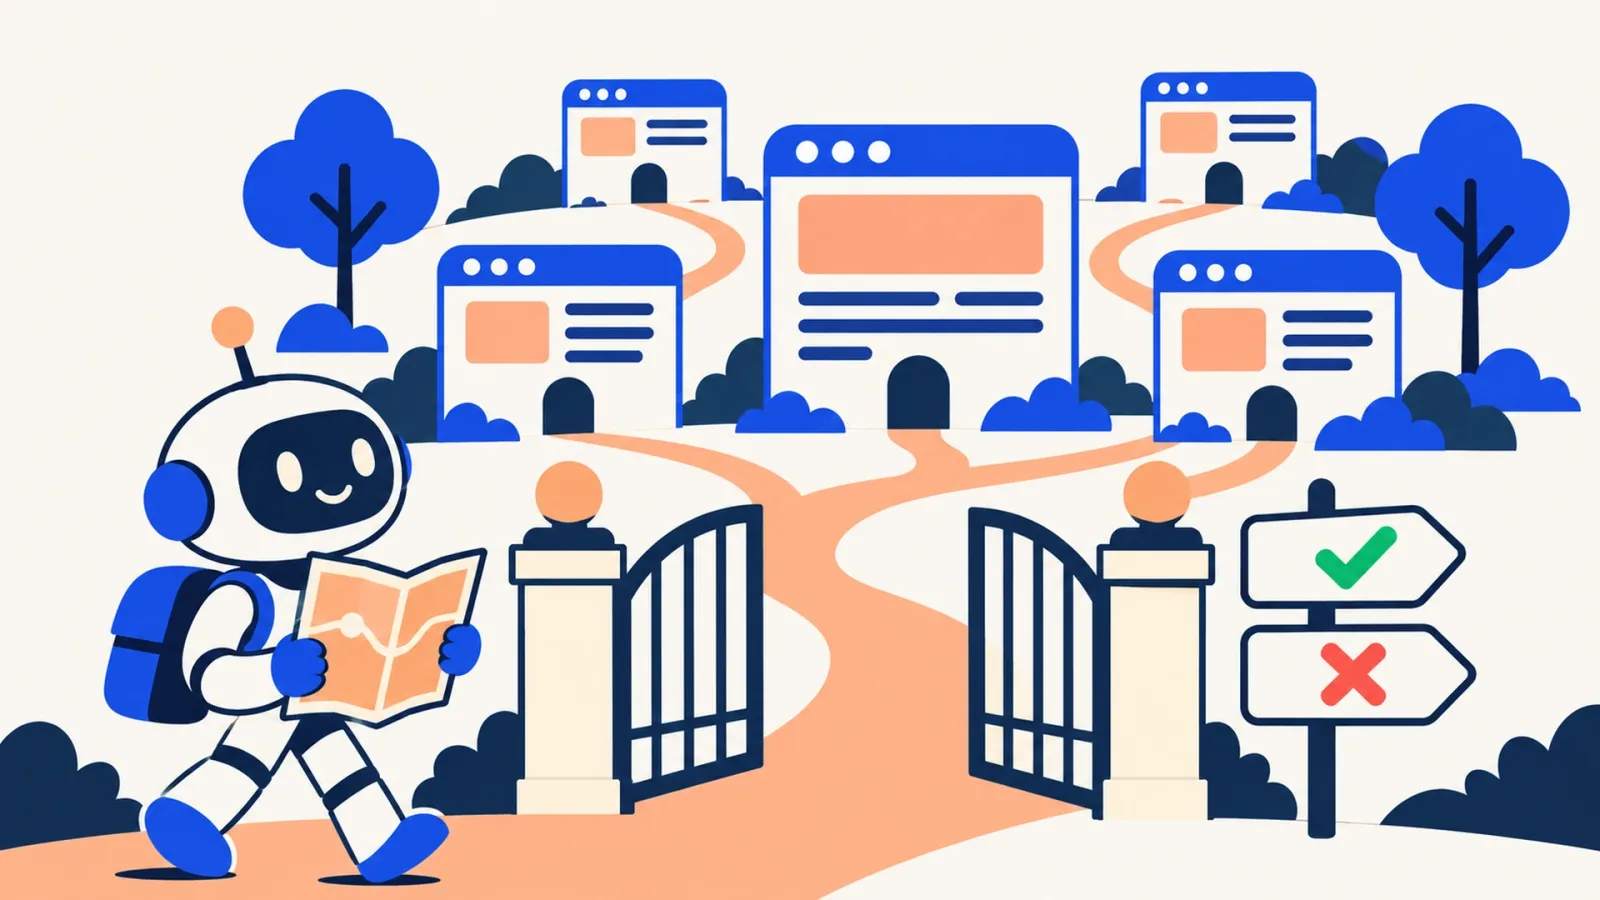
Google llega a sus páginas de dos formas: siguiendo enlaces y leyendo listas. El sitemap es esa lista: le dice a Google qué páginas existen. El robots.txt es la puerta: le dice a qué partes del sitio puede entrar.
Son dos archivos pequeños y casi siempre los crea solo su plataforma. Pero cuando uno de los dos está mal, puede dejar páginas importantes fuera de Google sin que nadie lo note.
Qué es un sitemap
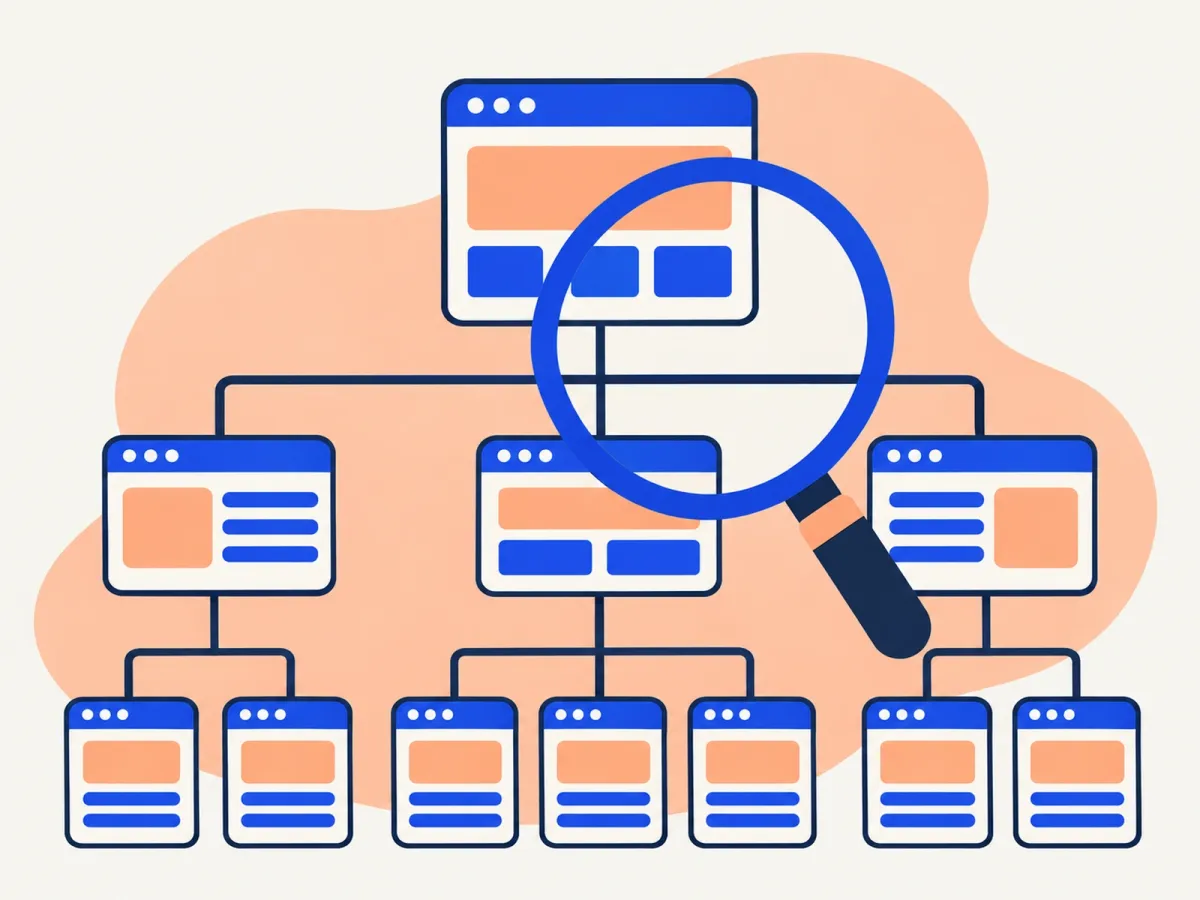
Un sitemap XML es un archivo con la lista de las páginas que usted quiere que Google encuentre. Suele estar en sudominio.com/sitemap.xml o, en WordPress con un plugin de SEO, en sudominio.com/sitemap_index.xml.
Cada página aparece con su dirección y, a veces, con la fecha de su última modificación:
<url>
  <loc>https://sudominio.com/servicios/</loc>
  <lastmod>2026-11-10</lastmod>
</url>
Lo que importa:
- Solo páginas que quiere en Google: con respuesta 200, sin redirección, sin noindex y con una canonical que apunte a sí misma.
- Direcciones finales: con
https, con o sinwwwsegún su sitio, iguales a las que usa en el menú. - Fecha de modificación real. Google la usa si es confiable. Si todas las páginas dicen que cambiaron hoy, deja de creerle.
- Prioridad y frecuencia de cambio (
priorityychangefreq) no hacen nada: Google las ignora. - Límite: 50.000 direcciones o 50 MB por archivo. Los sitios grandes usan un índice que agrupa varios sitemaps.
Un sitemap no obliga a Google a indexar nada. Es una sugerencia: le ayuda a descubrir páginas, sobre todo las nuevas y las que tienen pocos enlaces internos.
Qué es el robots.txt
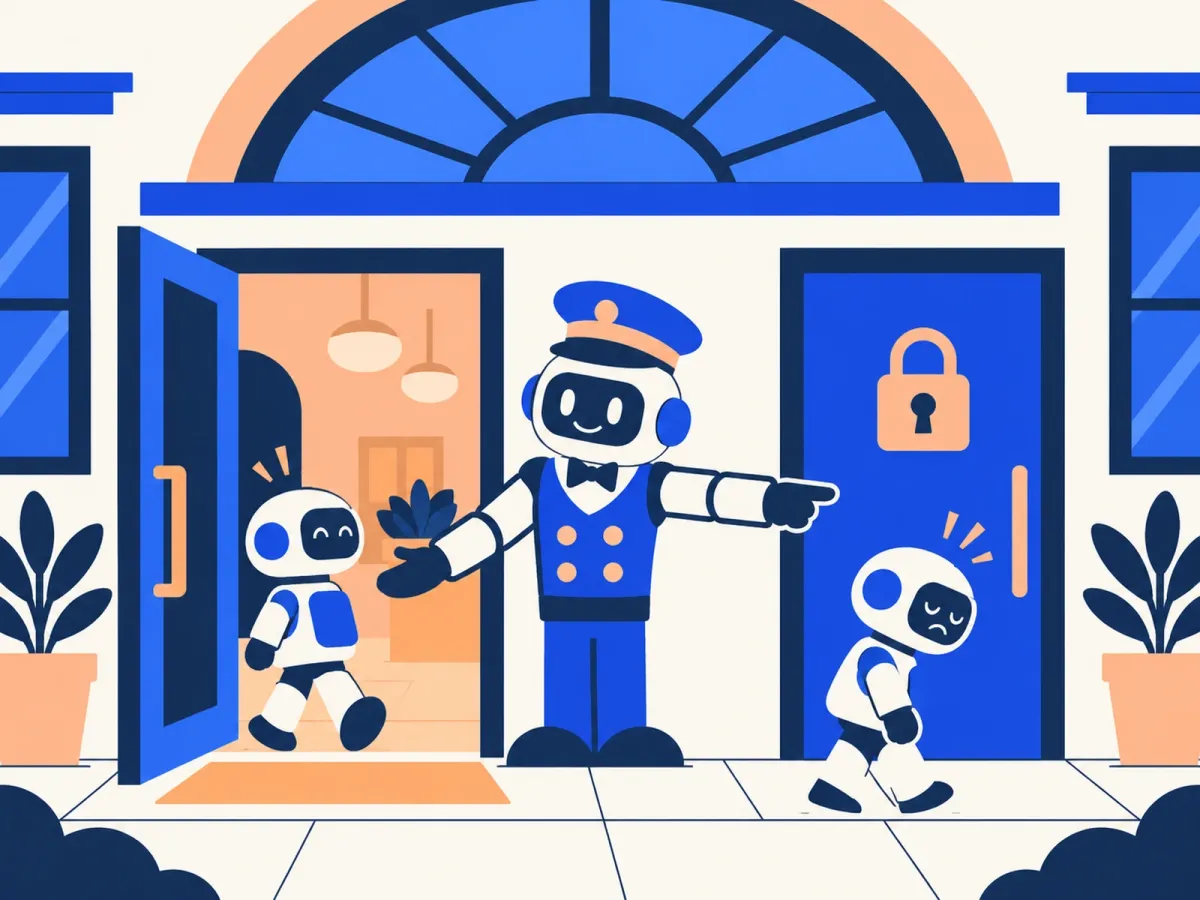
El robots.txt es un archivo de texto en la raíz del sitio (sudominio.com/robots.txt) con instrucciones para los rastreadores. Uno típico se ve así:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://sudominio.com/sitemap_index.xml
- User-agent dice a qué rastreador aplica la regla (
*es para todos). - Disallow bloquea una carpeta o dirección.
- Allow abre una excepción dentro de lo bloqueado.
- Sitemap le indica dónde está el sitemap, para que cualquier buscador lo encuentre.
Lo que más se malentiende: el robots.txt bloquea el rastreo, no la indexación. Si una página bloqueada tiene enlaces, Google puede mostrarla igual, sin descripción. Para que una página no salga en Google, use noindex y no la bloquee en robots.txt: si la bloquea, Google nunca ve el noindex.
Cómo revisarlos en cinco minutos
- Abra
sudominio.com/robots.txten el navegador. Busque una líneaDisallow: /sola: bloquea el sitio completo. - Abra el sitemap y revise que las direcciones sean las correctas (https, con o sin www, sin páginas de prueba).
- En Google Search Console, vaya a Sitemaps, pegue la dirección del sitemap y envíelo. Revise que el estado diga «Correcto» y cuántas páginas encontró.
- En Configuración → Informe de robots.txt, revise que Google lo haya leído sin errores.
- Haga lo mismo en Bing Webmaster Tools: Bing también alimenta a algunos asistentes de inteligencia artificial.
Robots.txt y los rastreadores de IA
El robots.txt también sirve para decidir si deja que los rastreadores de inteligencia artificial lean su sitio (por ejemplo GPTBot de OpenAI o Google-Extended de Google). Bloquearlos evita que usen su contenido, pero también puede hacer que su negocio aparezca menos en las respuestas de esos asistentes. Para la mayoría de los negocios que quieren clientes, conviene dejarlos entrar. Lo explicamos en SEO e inteligencia artificial.
Errores comunes
Disallow: /olvidado después de lanzar un sitio nuevo. Es el error más caro: el sitio entero queda fuera de Google.- Bloquear CSS o JavaScript. Google necesita esos archivos para ver la página como la ve un visitante.
- Bloquear en robots.txt una página que tiene noindex. Google no puede leer el noindex.
- Sitemap con páginas redirigidas, rotas o con noindex. Le resta confianza al sitemap completo.
- Sitemap viejo que no se actualiza al publicar páginas nuevas.
- Dos sitemaps distintos, por ejemplo uno del tema y otro del plugin, con direcciones diferentes.
Si Google no muestra algunas de sus páginas, revise también por qué Google no indexa mis páginas.
Preguntas frecuentes
¿Mi sitio necesita sitemap si es pequeño?
No es obligatorio: si todas las páginas están enlazadas desde el menú, Google las encuentra igual. Pero no cuesta nada y ayuda a que las páginas nuevas se descubran más rápido.
¿Tengo que enviar el sitemap cada vez que publico?
No. Basta con enviarlo una vez en Search Console. Google lo vuelve a leer por su cuenta.
¿Puedo esconder páginas privadas con robots.txt?
No. El robots.txt es público y cualquiera puede leerlo. Para páginas privadas use una contraseña; para páginas que no deben salir en Google, use noindex.
¿Cómo sé si Google tiene problemas con mi robots.txt?
Search Console muestra un aviso en el informe de robots.txt y en la Indexación de páginas, con el motivo «Bloqueada por robots.txt».
¿Quiere que revisemos cómo Google rastrea su sitio?
En el diagnóstico SEO revisamos el sitemap, el robots.txt, la indexación y las redirecciones, y le entregamos un plan priorizado. Vea los precios o escríbanos.
¿Prefiere hablar primero? Agende una reunión virtual gratuita o calcule el precio.
Siga leyendo
 Mercadeo Online · 19 de noviembre de 2026Actualizaciones de Google: qué hacer si su tráfico caeSu tráfico de Google bajó de repente. Cómo saber si fue una actualización, cómo encontrar qué páginas perdieron y qué hacer para recuperarlo, paso a paso.
 Mercadeo Online · 15 de noviembre de 2026Contenido duplicado: qué es y cómo resolverlo con la etiqueta canonicalQué es el contenido duplicado, por qué confunde a Google, cómo detectarlo en Search Console y cuándo usar la etiqueta canonical, una redirección 301 o noindex.
 Mercadeo Online · 15 de noviembre de 2026Cómo conectar Google Search Console a Google SheetsTres formas de llevar los datos de Search Console a Google Sheets: exportar, usar un complemento o la API. Y qué análisis hacer con ellos, paso a paso.